7.1 字符串就是字符数组
前面单元里你反复用数组管理单位、坐标、策略。这一单元你会发现一个重要真相:字符串(一段文字)其实也是一个数组——一个由字符排成队的数组。关卡说得斩钉截铁:"字符串就是一个数组!像数组一样遍历它。"掌握了这一点,你就能像检查军队一样,一个字一个字地检查名字,揪出名字里藏着 z 的间谍、破解 Thoktar 名字里的秘密。
len() 获取字符串长度、用 word[i] 按索引访问单个字符、用 for 循环遍历字符串的每个字符;并学会两个经典的字符串查找算法:一个返回布尔值(某字符在不在名字里),一个返回索引位置(某字符藏在名字的第几位)。
7.1.1 一串排好队的字符(Characters in a Row)
7.1.1.1 每个字符都有自己的位置 Each character has its own slot
把字符串想象成一排编了号的储物格:单词 "Reza" 就是四个格子,从左到右分别装着 R、e、z、a。和数组一模一样,这些格子从 0 开始编号:第 0 格是 R、第 1 格是 e、第 2 格是 z、第 3 格是 a。这套编号就是索引,是我们精确定位某个字符的钥匙。
7.1.2 长度与索引(Length and Index)
7.1.2.1 长度是"格子总数",索引最大是"长度减一" Length is the count, max index is length minus one
字符串的长度就是它有几个字符,用 len() 得到。"Reza" 有 4 个字符,len("Reza") 就是 4。但因为索引从 0 数起,合法索引是 0 到 len-1(也就是 0~3)。关卡的两个小例子把这两点说得很直观:"hero.say("Hello World"[0]) 英雄说 H;hero.say(len("Hello World")) 英雄说 11。"
7.2 按索引访问字符
7.2.1 word[i] 取单个字符(Getting One Character)
7.2.1.1 方括号加下标,取出那一格 Brackets with an index pull out one slot
和数组取元素完全一样,用方括号加索引 word[i] 就能取出字符串里第 i 个字符。比如 "Reza"[2] 得到 "z"。这是本单元一切操作的基石——无论是遍历还是查找,最终都要靠 word[i] 把某个位置的字符单独拎出来看一看。
word = "Reza"
hero.say(word[0])   # 说 "R"
hero.say(word[2])   # 说 "z"
character = word[i]   # 取出第 i 个字符,存进变量
7.2.2 len 获取字符串长度(Length with len)
7.2.2.1 遍历的边界由 len 决定 len defines the loop boundary
len(word) 告诉你字符串有多长,它是遍历时的"边界线"。要走遍每个字符,就让索引 i 从 0 走到 len(word) - 1——在 Python 里正好写成 range(len(word))。用 len() 而不是写死一个数字,代码就能应对任意长度的名字,无论是 3 个字母还是 30 个字母都通用。
len()、[i]、for 遍历,和第四单元数组的用法几乎一模一样。这正是编程的美妙之处——一套核心概念,处处适用。把字符串当数组看,你已经会的所有数组技巧都能直接迁移过来。
7.3 for 遍历字符串
7.3.1 逐个走过每个字符(Visiting Every Character)
7.3.1.1 用 range(len(...)) 逐位访问 Loop over range(len(...))
遍历字符串的标准套路是:for i in range(len(word)) 让 i 从 0 依次取到最后一位,每轮用 word[i] 取出当前字符来处理。关卡给的例子把每个字母逐一念出来:
string = "Hello, World!"
for i in range(len(string)):
    letter = string[i]       # 取出第 i 个字符
    hero.say(letter)          # 英雄逐一讲出每个字母
7.3.2 两种遍历写法(Two Ways to Iterate)
7.3.2.1 按索引 vs 直接取字符 By index vs. directly by character
遍历字符串有两种常见写法。一种是按索引(for i in range(len(word)),再 word[i]),当你需要知道"字符在第几位"时必须用它。另一种是直接取字符(for character in word),当你只关心字符本身、不在乎位置时更简洁。本单元两关正好各展示一种思路。
按索引(能拿到位置 i)
for i in range(len(word)):
    char = word[i]
    # 知道 char 在第 i 位
直接取字符(更简洁)
for char in word:
    # 直接拿到每个字符
    # 但不知道它在第几位
i 的写法。选写法前先问自己:我需要位置信息吗?
7.4 遍历查找字符
7.4.1 找到就返回(Return As Soon As Found)
7.4.1.1 边遍历边比较,一命中就交差 Compare while looping, return on the first hit
查找的通用模式是:遍历每个字符,逐一和目标比较,一旦相等就立刻返回结果。因为 return 会立即结束函数,所以找到目标那一刻循环就停了,不会做无用功。如果整个字符串走完都没找到,就在循环之后返回一个"没找到"的默认值。这个"循环内找到即返回、循环后兜底"的结构,是查找算法的标准骨架。
7.4.2 返回布尔:有没有(Return a Boolean)
7.4.2.1 letterInWord —— 判断字符在不在 letterInWord — does it contain the letter
"我们中间的间谍"的 letterInWord(word, letter) 回答的是"是/否"问题:这个名字里有没有某个字母?算法是:遍历每个字符,若某个字符等于目标字母,立刻 return True;若遍历完都没匹配上,最后 return False。返回的是一个布尔值,正好能直接拿去做 if 判断。
def letterInWord(word, letter):
    for i in range(len(word)):
        character = word[i]
        if character == letter:   # 找到了!
            return True            # 立即回报"有"
    return False                   # 走完都没有 → "没有"
7.4.3 返回索引:在哪里(Return an Index)
7.4.3.1 letterIndex —— 报出字符的位置 letterIndex — where the letter sits
"以我的名义"的 letterIndex(word, letter) 回答的是"在哪"问题:某字母藏在名字的第几位?算法几乎一样,只是命中时不再返回 True,而是返回当前的索引 i(一个数字)。因为要用到位置,这里必须用带 i 的索引遍历。没找到则返回一个默认值(如 -1 或 0)。
def letterIndex(word, letter):
    for i in range(len(word)):
        char = word[i]
        if char == letter:      # 找到目标字母
            return i               # 返回它所在的索引(数字)
    return -1                    # 没找到的默认值
letterInWord 和 letterIndex 的循环结构完全相同,唯一区别是命中时"回报什么":一个报 True(在不在),一个报 i(在哪里)。掌握一个查找骨架,改改返回值就能解决一大类问题——这正是算法思维的迁移力。
7.5 实战关卡精讲
这一节聚焦每一关的策略、思路与算法设计,只展示用于说明的关键片段,完整通关程序请你自己动手完成。
🕵️ 我们中间的间谍 —— 找出名字带 z 的人
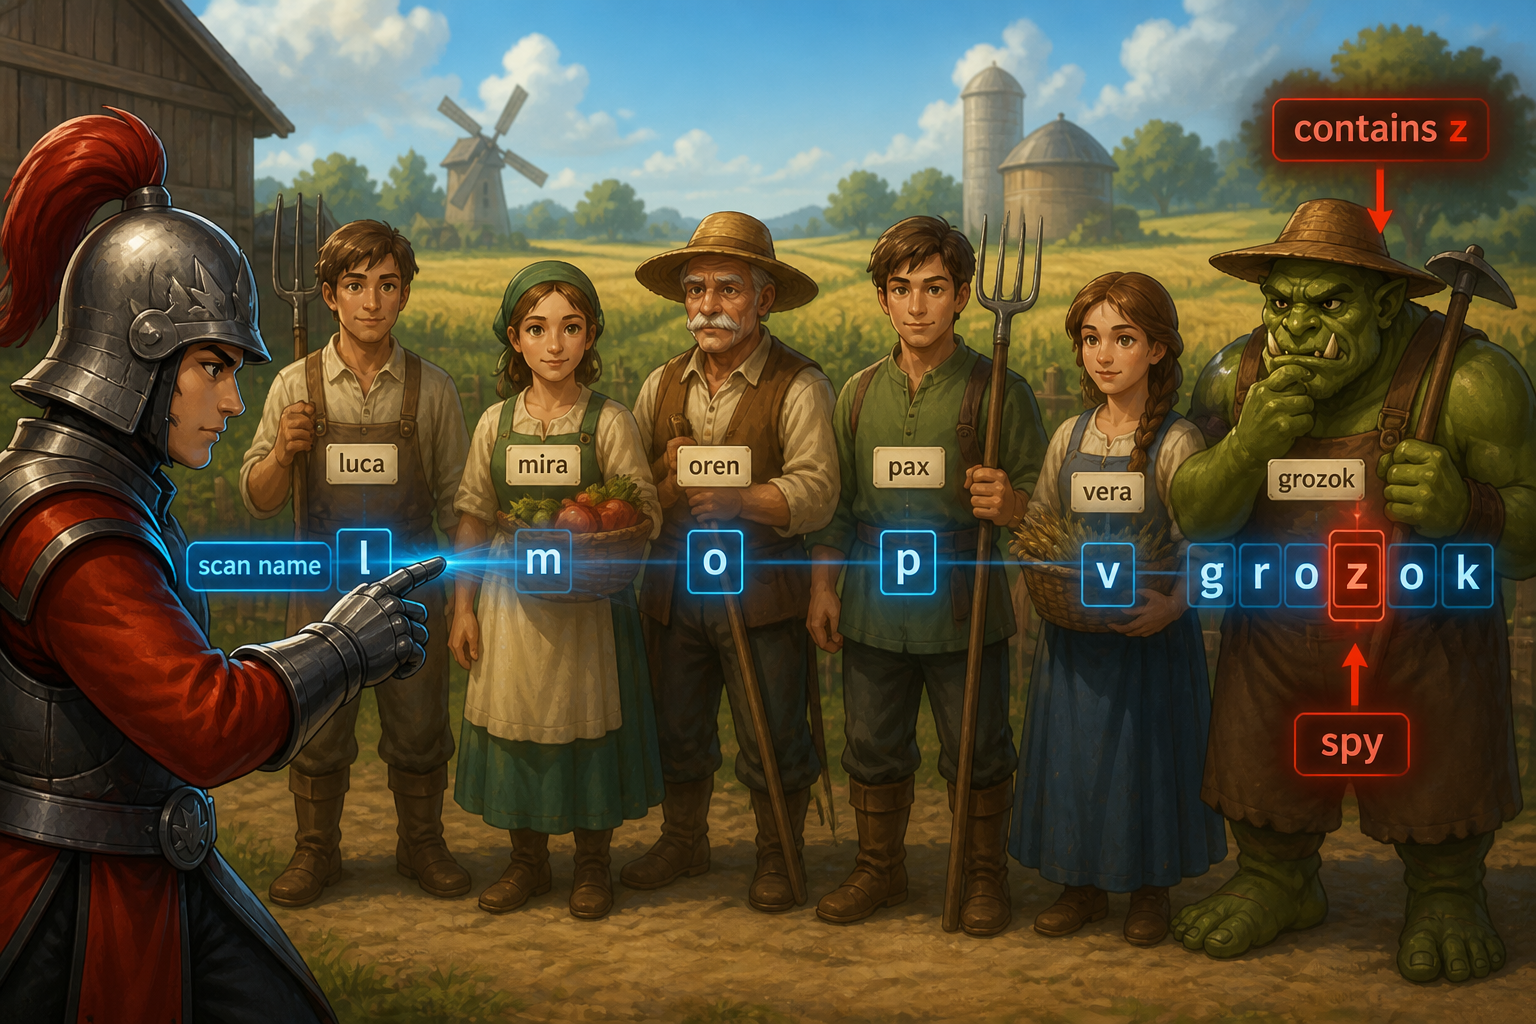
策略:用名字里的破绽揪出间谍
本关的线索很妙:内门能撑很久,真正的威胁是混在农民里的间谍,而间谍的名字里藏着字母 "z"。策略就是逐一检查每个朋友的名字,谁的名字里带 z,谁就是间谍,把他喊出来揭穿;名字干净的就是真朋友。
思路拆解:内外两层遍历
算法是"双层遍历"。外层遍历所有朋友,取出每个人的名字 friend.id。内层(封装在 letterInWord 里)遍历这个名字的每个字符,判断有没有 z。补全 letterInWord 的关键就一句:当 character == letter 时 return True,让"找到即返回"的骨架完整起来。主循环再用它的布尔返回值做 if 分流:是间谍就喊 "is a spy!",否则喊 "is a friend."。
# 关键片段:补全查找骨架 + 外层逐人检查
def letterInWord(word, letter):
    for i in range(len(word)):
        if word[i] == letter:
            return True
    return False

spyLetter = "z"
for friend in hero.findFriends():
    if letterInWord(friend.id, spyLetter):
        hero.say(friend.id + " is a spy!")
    # else: 喊出他是朋友
id 是它的名字字符串。把 friend.id 传进 letterInWord,就是在检查"这个人的名字里有没有 z"。这也再次印证了本单元的核心——名字是字符串,字符串是数组,所以能一格一格地查。
"z" 和 "Z" 在计算机看来是不同的字符。若线索是小写 z,而某个名字里是大写 Z,直接比较是匹配不上的。本关按小写 z 匹配即可,但这个"大小写敏感"的坑值得记住,以后处理文本时常会遇到。
🗝️ 以我的名义 —— 用字符索引锁定宝箱
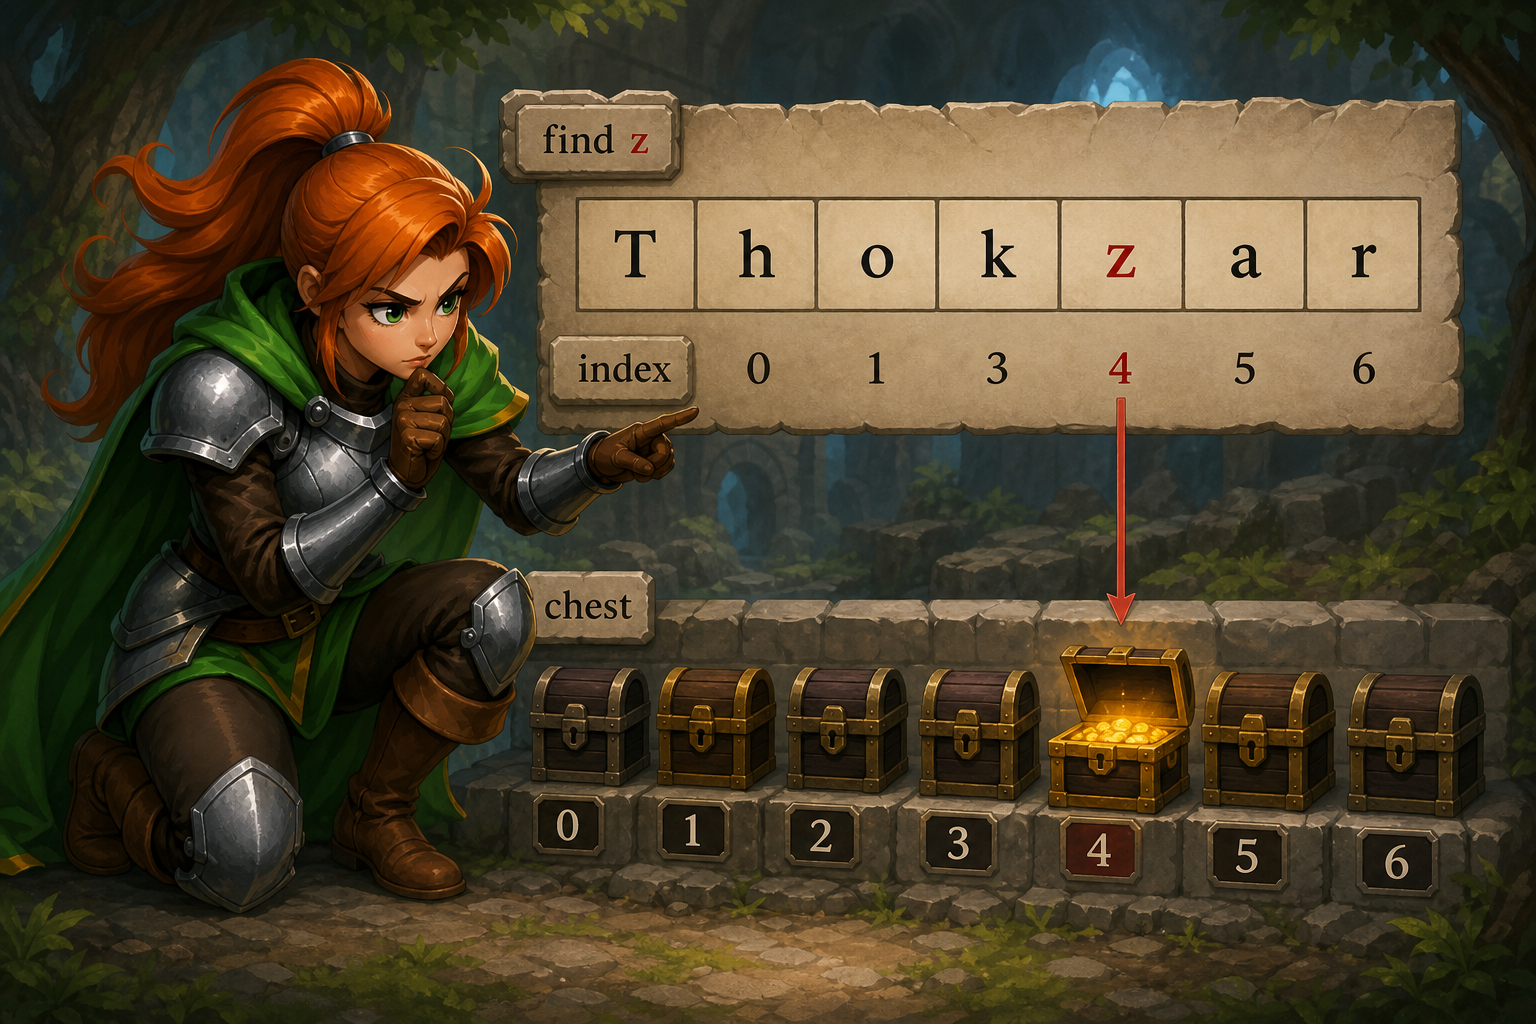
策略:名字里的 z 指向正确宝箱
本关只有一次机会:面前一排宝箱,只有一个装着宝藏,选错骷髅就会夺走奖品。破解的钥匙藏在 Thoktar 的名字里——正确宝箱的编号,等于字母 z 在 Thoktar 名字中的索引。所以策略是:算出 z 在名字里的位置,再据此走到对应的宝箱。
思路拆解:返回索引 + 坐标换算
核心是补全返回索引的 letterIndex。用带 i 的遍历逐个检查名字字符,一旦 char == letter 就 return i(这个数字就是宝箱编号);找不到则返回默认值。拿到 chestIndex 后,关卡用一个线性公式把"编号"换算成"坐标":hero.moveXY(16 + chestIndex * 8, 36)——每个宝箱间隔 8 格,从起点 16 开始,第 chestIndex 个箱子就在 16 + 编号 × 8 处。
# 关键片段:返回 z 的索引,再换算成宝箱坐标
def letterIndex(word, letter):
    for i in range(len(word)):
        if word[i] == letter:
            return i          # z 的位置 = 宝箱编号
    return 0                 # 没找到的默认值

ogreLetter = "z"
shaman = hero.findByType("thoktar")[0]
chestIndex = letterIndex(shaman.id, ogreLetter)
hero.moveXY(16 + chestIndex * 8, 36)
16 + chestIndex * 8 是一个典型的线性换算:16 是第 0 号箱子的起始 x 坐标,8 是相邻箱子的间距。索引每加 1,坐标就右移 8。这种"用编号乘以间距再加起点"的公式,在把"第几个"变成"在哪里"时极其常用。
0,意味着默认走向第 0 号箱子。但更严谨的写法常返回 -1 表示"没找到",让调用方能明确区分"在第 0 位"和"根本不存在"。这一关因为 z 一定存在,返回什么默认值影响不大;但养成用 -1 表达"查无此项"的习惯,能避免日后把"没找到"误当成"在开头"。
7.6 常见错误
7.6.1 字符遍历与查找的坑(Pitfalls)
7.6.1.1 字符串相关的常见问题 Typical issues with string iteration
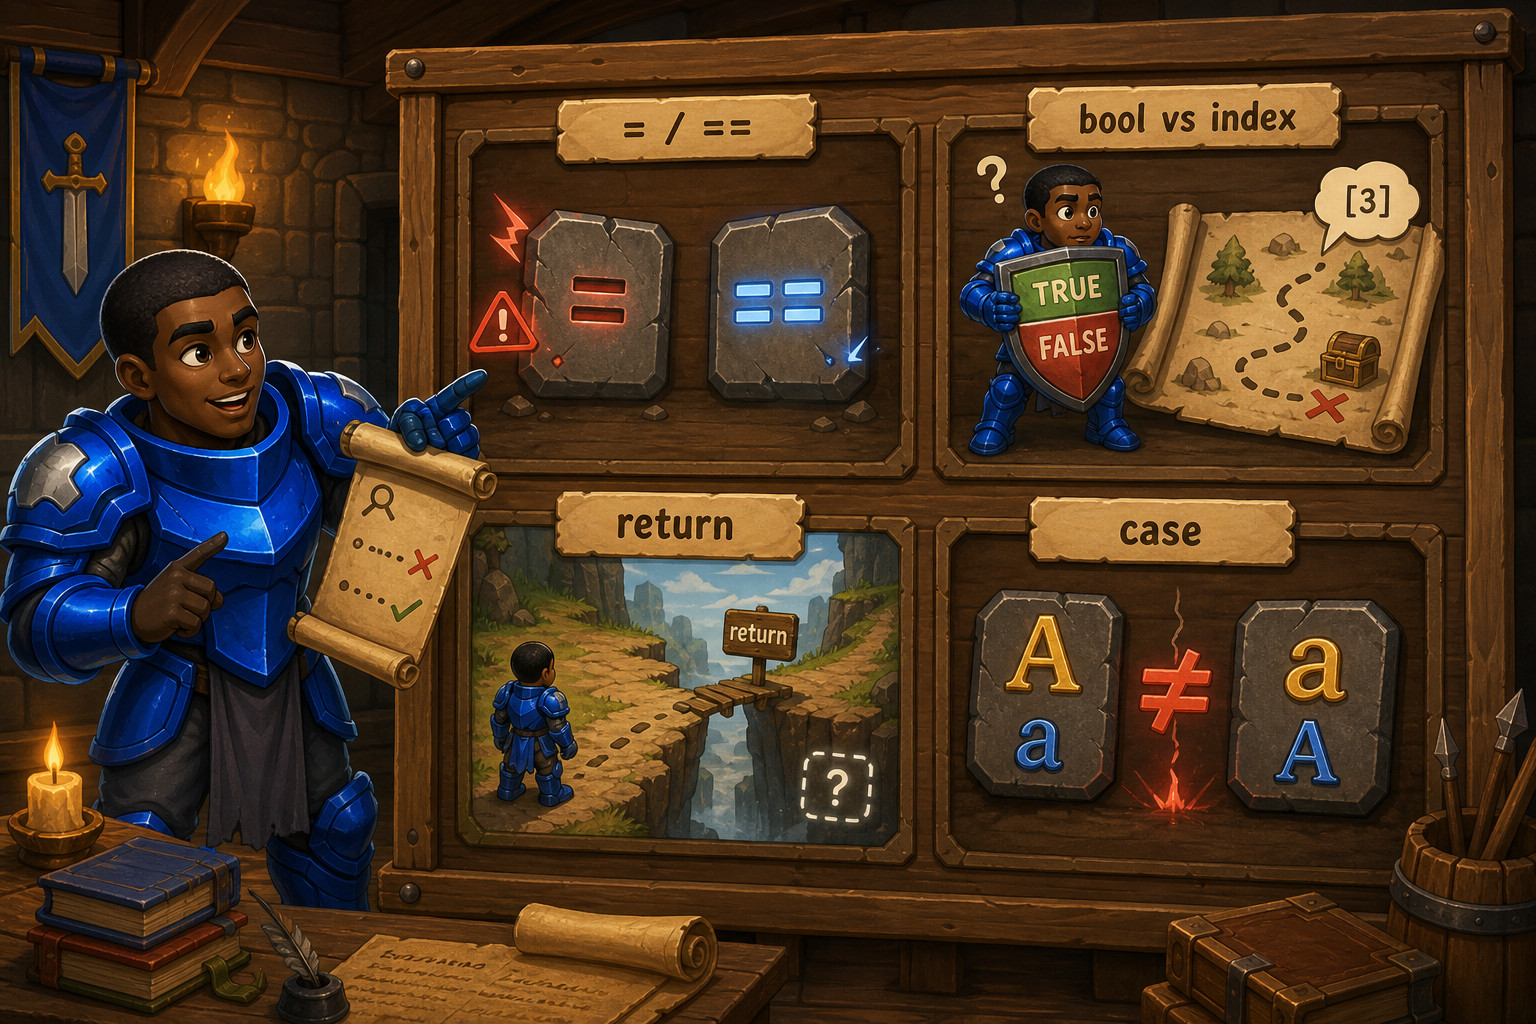
- 比较字符用了
=——判断字符相等要用==,=是赋值,写错会报错。 - 该返回索引却返回了
True——letterIndex命中时要return i(数字),不是return True。 - 忘写循环后的兜底返回——没找到时若不
return False/return -1,函数会返回None,逻辑出错。 - 把兜底 return 写进循环里——
return False应在for之外,写在循环里会只查第一个字符就退出。 - 索引越界——用
word[len(word)]会越界;合法索引最大是len(word) - 1。 - 大小写不匹配——
"z"与"Z"是不同字符,需要时可先统一大小写再比较。 - 忘了取当前字符——写了
for i in range(...)却直接比较i,应先word[i]取出字符再比。 - 只关心"有没有"却用了带 i 的复杂写法——只判断存在时,
for c in word更简洁;要位置才用索引。 - 坐标换算公式记错——"编号→坐标"是
起点 + 编号 × 间距,别漏了起点或间距。
本单元小结 ✨
恭喜你解锁了处理文字的能力!这一单元你领悟了一个关键观念——字符串就是字符的数组:可以用 len() 量长度、用 word[i] 按索引取字符、用 for 循环逐个遍历。你还掌握了查找算法的通用骨架"遍历比较、命中即返回、走完兜底",并用它写出两个变体:letterInWord 返回布尔值(名字里有没有 z)帮你揪出间谍,letterIndex 返回索引(z 在第几位)帮你锁定藏宝的宝箱。来回顾一下核心概念:
| 核心概念 | 关键点 | 对应关卡 |
|---|---|---|
| 字符串即数组 | 字符排成队,索引从 0 开始 | 两关 |
| len 取长度 | 字符个数,遍历的边界 | 两关 |
| word[i] 取字符 | 方括号加索引取出单个字符 | 两关 |
| for 遍历字符串 | range(len(word)) 逐位访问 | 两关 |
| 查找骨架 | 比较→命中即 return→走完兜底 | 两关 |
| 返回布尔 | letterInWord:在不在 | 间谍 |
| 返回索引 | letterIndex:在第几位 | 以我的名义 |
| 索引→坐标 | 起点 + 编号 × 间距 | 以我的名义 |
懂得把一个个名字拆成字符、从字里行间读出秘密的英雄,才是云峰之上真正明察秋毫的程序员。
继续向雪山之巅挺进吧,勇敢的程序员!🏔️🕵️🗝️
扣哒世界 编程知识 · 计算机科学 5(安息云峰):第七单元
扣哒世界教研团队