8.1 什么是子串匹配
在前面的旅程里,你已经能召唤军队、指挥作战、用函数封装行为、用循环遍历数组和字典。现在食人魔耍起了阴招——它们在大门附近立起怪异的雕像,施放黑魔法,普通士兵一走近就会被吞噬,只有高地居民(Highlander)才能免疫。可英雄手下的士兵混在一起,谁是高地人呢?线索只有一条:高地人的名字里总是包含 "mac"。要把他们一个个挑出来,你需要一件全新的工具——子串匹配(substring matching)。
wordInString(string, word) 函数,用下标访问取出每个字符、用双重循环在长字符串的每个起点上尝试对齐、用逐字符比较判断是否吻合、用 break 提前中断失败的尝试,最终判断名字里到底有没有 "mac"。
8.1.1 子串与包含关系(Substring & Containment)
8.1.1.1 什么叫"子串" A substring is a contiguous slice
子串指的是原字符串中连续的一段字符。比如 "Fangrimac" 里,从第 6 个字符起的 "mac" 就是它的一个子串;而 "mca"(顺序被打乱)就不是,"mac" 里字符必须紧挨在一起、顺序一致。判断长字符串里是否含有某个子串,就叫"子串匹配"或"字符串包含检测"。
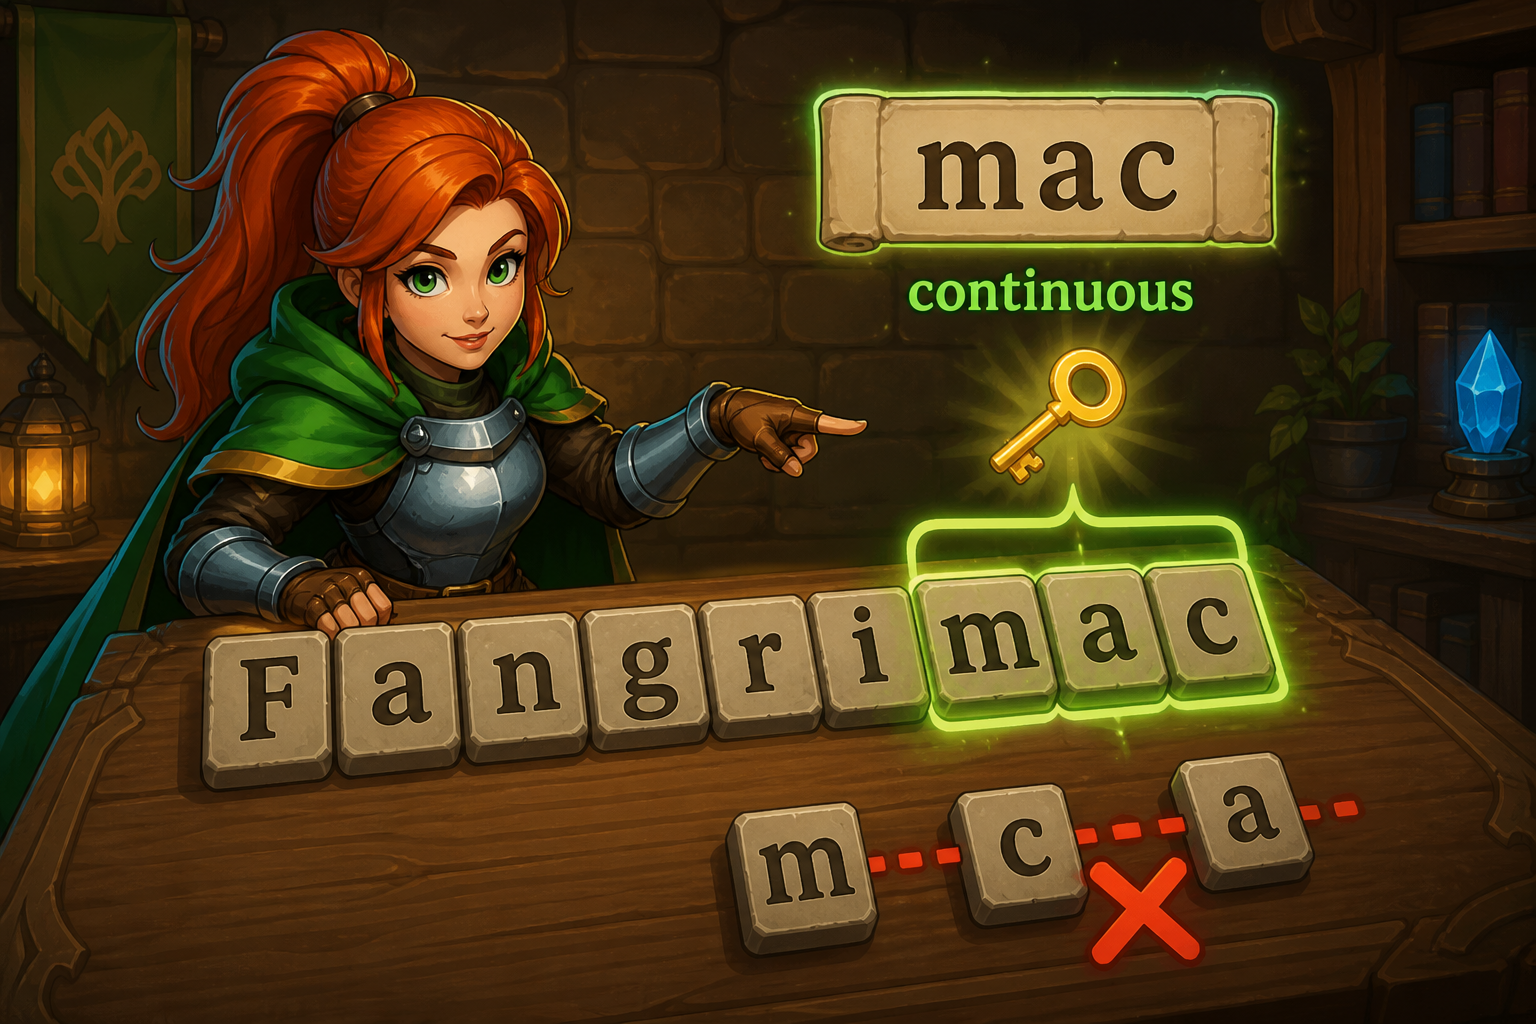
"mac" 在 "Macbeth"(不区分大小写时)、"Fangrimac"、"macGyver" 中都连续出现。不是子串:
"mac" 不在 "Camo"(有 m、a、c 但不连续)、"Reynaldo"(根本没有)里。
8.1.2 大海捞针的思路(The Needle in a Haystack)
8.1.2.1 haystack 与 needle The long string vs. the short target
算法界习惯把这两个字符串叫作 haystack(干草堆,被搜索的长字符串)和 needle(针,要找的短子串)。这个比喻很形象——在一大堆干草里找一根针。本关里,士兵的名字 soldier.id 就是 haystack,"mac" 就是 needle。核心问题是:这根"针"到底藏没藏在"草堆"里?
8.2 字符串的下标访问
8.2.1 len 与 string[i](Length and Indexing)
8.2.1.1 字符串像一排带编号的格子 A string is a row of numbered cells
字符串在内存里就像一排格子,每个格子放一个字符,从 0 开始编号。用 len(string) 得到它的长度(格子总数),用 string[i] 取出第 i 个格子里的字符。注意:合法下标是从 0 到 len(string) - 1,取 string[len(string)] 会越界报错。
8.2.2 逐字符比较(Character-by-Character Comparison)
8.2.2.1 用 == 比对两个字符是否相同 Compare characters with ==
子串匹配的最小单位就是"比较两个字符是否相等"。取出 haystack 的某个字符和 needle 的某个字符,用 == 判断它们是否一样。整段子串是否匹配,就是把 needle 里的每个字符都逐一比对通过。这个"逐字符"的思想是整个算法的基石。
# 取长度、取字符、比字符
string = "Fangrimac"
word = "mac"

print(len(string))   # 9
print(string[6])     # "m"
print(string[6] == word[0])  # True,'m' == 'm'
8.3 单指针滑动法
在正式写双重循环之前,关卡先用一个更直观的思路帮你热身:只走一遍 haystack,用一个"计数指针" needleIndex 记录"到目前为止 needle 已经连续匹配到第几位"。这是关卡说明里给出的示范片段。
8.3.1 needleIndex 计数器(The Match Counter)
8.3.1.1 它记录"已连续匹配的进度" It tracks how far the needle matched so far
needleIndex 从 0 出发。每当 haystack 的当前字符与 needle[needleIndex] 相同,就说明"针"又对上了一位,把 needleIndex 加 1,指向针的下一个待比字符。一旦 needleIndex 达到 needle 的长度,就说明整根针都连续对齐过了——找到了!
haystack = "Hello, world!"
needle   = "o, w"
needleIndex = 0

for i in range(len(haystack)):
    letter = haystack[i]
    # 当前字符与"针"的当前待比字符是否相同?
    if letter == needle[needleIndex]:
        needleIndex += 1          # 对上一位,指向下一位
        if needleIndex >= len(needle):
            hero.say("Yep! found it!")
            break                   # 整根针都对上了!
    else:
        needleIndex = 0          # 断了,从头再来
8.3.2 匹配、前进与重置(Match, Advance, Reset)
8.3.2.1 关键在"断了就重置" On a mismatch, reset the counter
这段代码的灵魂是那个 else: needleIndex = 0。只要当前字符对不上,就意味着"从刚才那个起点开始的连续匹配断了",必须把计数器清零、从头再数。因为子串要求"连续",中途断一次,前面攒的进度就全作废了。下面用 needle="o, w" 在 "Hello, world!" 上逐帧演示计数器怎么涨、怎么归零。
| i | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
|---|---|---|---|---|---|---|---|---|---|
| 字符 | H | e | l | l | o | , | w | o | |
| needleIndex→ | 0 | 0 | 0 | 0 | 1 | 2 | 3 | 4✓ | — |
"o",计数器一直是 0;到下标 4 遇到 "o" 开始连续对上 o、,、空格、w,计数器涨到 4,等于 len("o, w"),匹配成功,break 退出。
8.4 双重循环法
关卡真正要你在 wordInString 里实现的,是更经典、更通用的双重循环解法:外层枚举 haystack 里每一个"可能的起点",内层从这个起点出发,把 needle 逐字符对齐比较。这也叫"朴素字符串匹配(naive string matching)"。
8.4.1 外层选起点 i(Outer Loop: Choose a Start)
8.4.1.1 只需枚举到 lenString - lenWord Start positions stop at lenString − lenWord
外层循环变量 i 表示"把 needle 的头对齐到 haystack 的第 i 个字符上"。这里有个重要优化:起点不必枚举到字符串末尾。如果剩下的字符还没 needle 长,就绝不可能装得下它了。所以 i 只需从 0 走到 lenString - lenWord,超过这个位置继续找是浪费。
8.4.2 内层比对 j(Inner Loop: Compare Each Char)
8.4.2.1 用 string[i+j] 对齐 word[j] Align string[i+j] with word[j]
内层循环变量 j 从 0 到 lenWord - 1,逐个检查 needle 的每个字符。关键在下标的对齐关系:needle 的第 j 个字符 word[j],应当对应 haystack 里 string[i + j] 这个位置——因为整根针的头放在了 i,那么针的第 j 位自然落在 i + j。这个 i + j 的下标换算是本关最需要理解透的一点。
8.4.3 break 与完整匹配(Break & Full Match)
8.4.3.1 一处不合就 break,全对到底就 return True Break on mismatch, return True on full match
内层比对有两个出口。其一,只要 string[i+j] != word[j],这个起点就废了——用 break 立刻跳出内层,回到外层换下一个起点,没必要再比后面的字符。其二,如果一路比到了 needle 的最后一位(j == lenWord - 1)都还相等,就说明整根针完整匹配,直接 return True。如果所有起点都试遍了还没成功,函数最后 return False。下面是关卡里 wordInString 的核心逻辑片段。
# wordInString 的核心:双重循环 + break + 完整匹配判断
def wordInString(string, word):
    lenString = len(string)
    lenWord = len(word)
    # 外层:逐个起点 i(只需到 lenString - lenWord)
    for i in range(0, lenString - lenWord):
        # 内层:逐字符比对 needle 的每一位 j
        for j in range(lenWord):
            if string[i + j] != word[j]:
                break                   # 断了,换下一个起点
            elif j == lenWord - 1:
                return True            # 最后一位也对上,完整匹配!
    return False                       # 所有起点都失败
elif j == lenWord - 1 必须写成 if ... break 的否则分支。含义是"这一位相等(没进 break),而且它正好是最后一位"——两个条件同时成立,才能确信整根针都对齐了。若这一位不是最后一位,就什么都不做,让内层循环继续比下一位 j。
lenString - lenWord + 1(即 range(0, lenString - lenWord + 1))。关卡示范代码用的是 lenString - lenWord,对本关名字里的 "mac" 已经够用;但当你把这套算法用到其它场景、尤其是子串恰好在字符串结尾时,记得把上界加 1 才不会漏判。
8.5 实战关卡精讲
这一节聚焦关卡的策略、思路与算法设计,只展示用于说明的关键片段,完整通关程序请你自己动手完成。
⛰️ 高原者 —— 只召唤名字含 "mac" 的高地人
关卡背景与目标
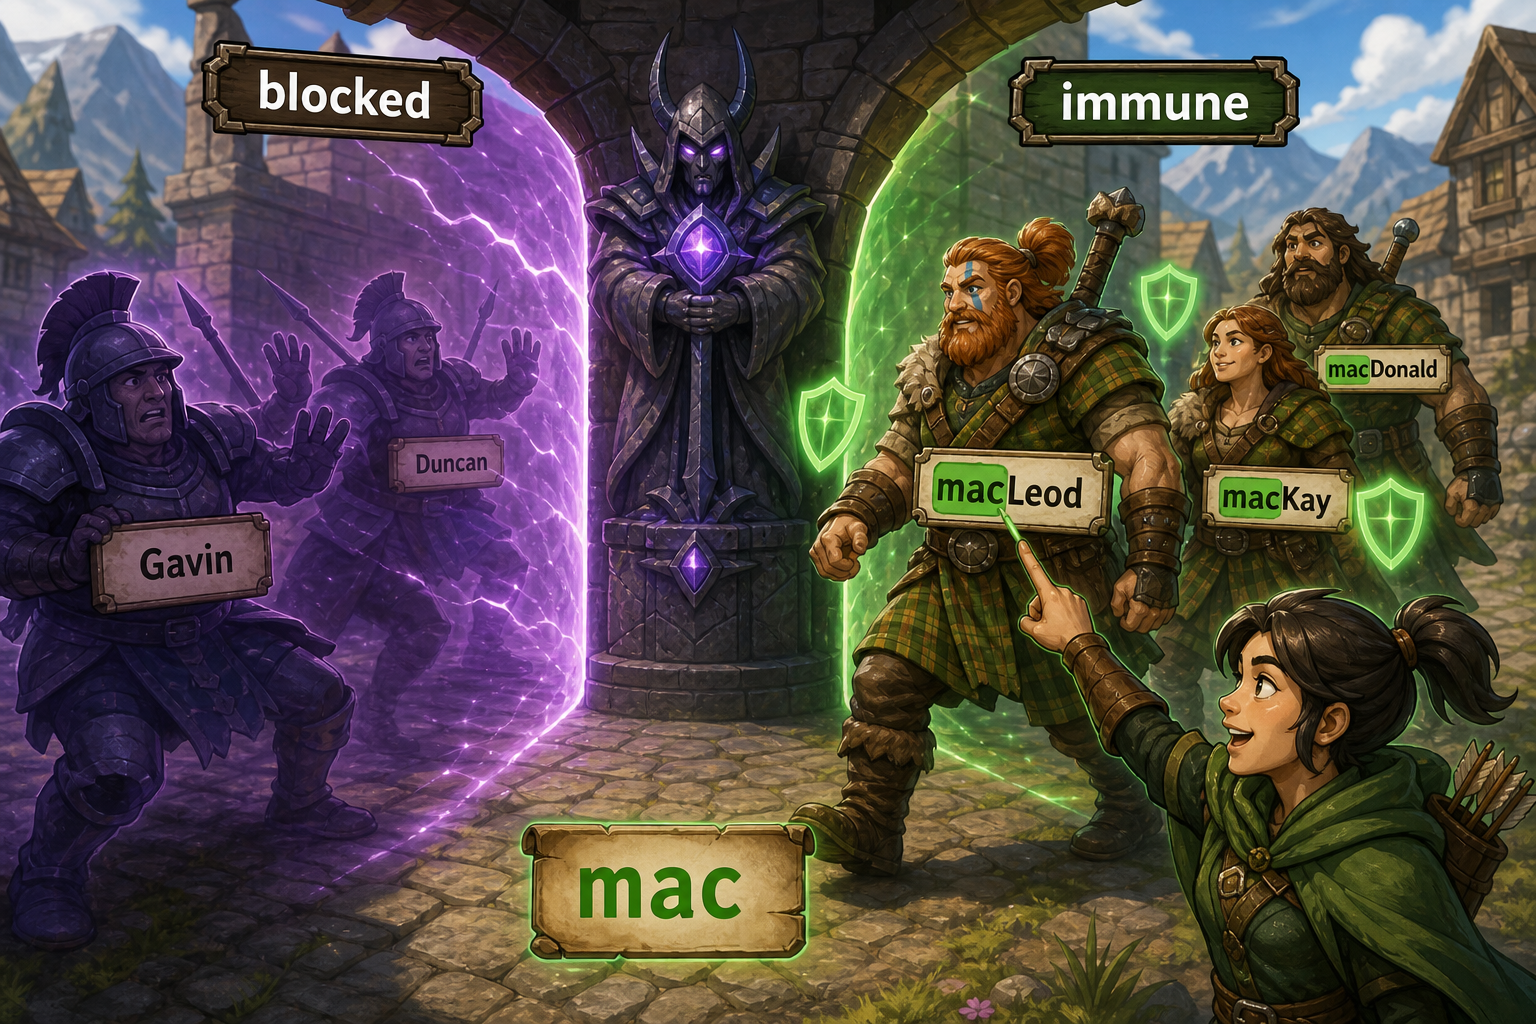
食人魔在大门附近立起施放黑魔法的雕像,没有防御地走过去,你的士兵就会损失。只有高地居民免疫这种黑魔法。而识别高地人的唯一线索是:他们的名字里总是包含 "mac"。所以你要遍历所有盟友,用子串匹配把名字含 "mac" 的人挑出来、让他们做好战斗准备,然后一声令下发起进攻。
策略:写好"检测器",再筛人
本关的策略分两层。第一层是写工具:补全 wordInString(string, word) 函数,让它能可靠回答"word 是不是 string 的子串"。第二层是用工具筛人:用 hero.findFriends() 拿到所有盟友,对每个 soldier 调用 wordInString(soldier.id, highlanderName),返回 True 的就是高地人,让他 hero.say(soldier.id + " be ready.");筛完后统一 hero.say("ATTACK!!!")。
思路拆解
算法的核心全在 wordInString 里,就是 8.4 讲的双重循环。默认代码已经给好 lenString、lenWord 两个长度变量,并用注释把每一步都提示清楚:"从 0 到 (lenString − lenWord) 遍历索引 i;对每个 i,遍历索引 j 到 word 的长度;如果 string[i+j] != word[j] 则中断循环;如果这是 word 的最后一个字母(j == lenWord - 1)则返回 True;如果循环结束都没成功,返回 False。"你要做的就是把这些注释翻译成 8.4 里那段双重循环代码,并删掉占位用的那行 return True。
# 关键片段:遍历盟友,用子串匹配筛出高地人
highlanderName = "mac"

soldiers = hero.findFriends()
for soldier in soldiers:
    if wordInString(soldier.id, highlanderName):
        hero.say(soldier.id + " be ready.")

hero.say("ATTACK!!!")
return True 并注明"在写好函数后删除它"。如果不删,函数会对任何名字都返回 True,把普通士兵也当成高地人送去送死。写完双重循环后,务必把这行占位删掉。
wordInString,主循环就只需一句 if wordInString(...) 就能表达"这个人是不是高地人",非常清晰。这正是前面单元学的"用函数封装行为"和本单元"子串匹配算法"的结合——算法藏在函数里,主逻辑读起来像自然语言。
string.lower() 与 word.lower())再比较——这是一个值得记住的扩展技巧。
8.6 算法进阶与复杂度
8.6.1 时间复杂度(Time Complexity)
8.6.1.1 朴素匹配是 O(n × m) Naive matching costs O(n × m)
设 haystack 长度为 n、needle 长度为 m。外层有大约 n 个起点,每个起点内层最多比 m 个字符,所以最坏情况下要做约 n × m 次比较,记作 O(n × m)。对本关这种短名字(needle 只有 3 个字符),这完全够快。但如果 haystack 和 needle 都很长、又有大量"差一点就匹配"的情形,朴素法会显得慢。
8.6.2 内置方法对照(Built-in Alternatives)
8.6.2.1 现实中一句 in 就够 In real Python, "in" does it in one line
关卡让你亲手实现子串匹配,是为了理解底层原理。而在真实的 Python 编程里,判断子串通常一行就够——用 in 运算符,或用字符串的 find/index 方法。理解了手写版,再用内置版,你才知道它们背后在做什么。
手写版(理解原理)
if wordInString(name, "mac"):
    ...
# 双重循环,自己判断
内置版(日常首选)
if "mac" in name:
    ...
# in 直接返回 True/False
| 写法 | 作用 | 返回值 |
|---|---|---|
"mac" in name | 判断是否包含子串 | True / False |
name.find("mac") | 找到子串首次出现的下标 | 下标;找不到返回 -1 |
name.index("mac") | 同 find,但找不到时报错 | 下标;找不到抛异常 |
name.count("mac") | 统计子串出现次数 | 整数次数 |
8.7 常见错误
8.7.1 新手最容易踩的坑(Pitfalls for Beginners)
8.7.1.1 子串匹配的典型问题 Typical issues in substring matching
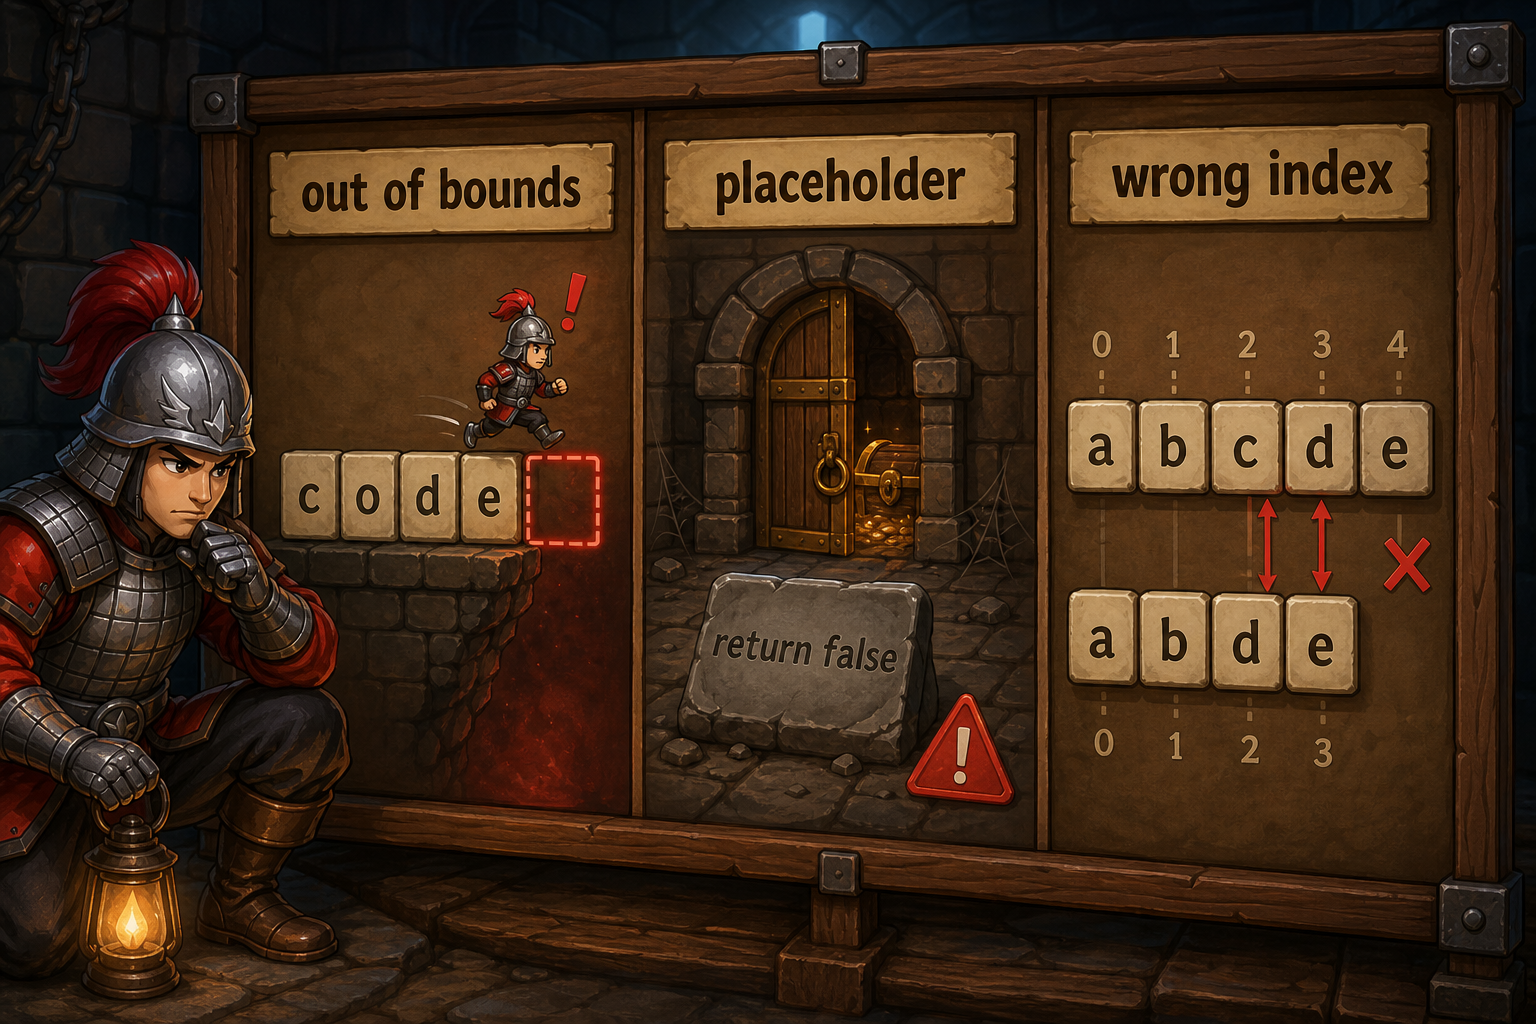
- 忘删占位的
return True——它会让函数对任何输入都返回真,普通士兵被误判为高地人。写完逻辑一定要删掉它。 - 下标对齐写错——应是
string[i + j]对齐word[j],写成string[i]或string[j]都会算错。 - 完整匹配判断漏了——只
break却忘了写elif j == lenWord - 1: return True,函数永远不会返回真。 - break 与 return 位置混乱——不匹配才
break(换起点),匹配到最后一位才return True;两者不能对调。 - 下标越界——外层起点若不限制在
lenString - lenWord附近,string[i + j]会超出字符串长度而报错。 - 单指针法忘了重置——用
needleIndex计数时,遇到不匹配一定要needleIndex = 0,否则会错判非连续的匹配。 - 大小写不一致——
"Mac"与"mac"不相等;需要忽略大小写时先统一转小写。 - 函数没被调用/没删占位就筛人——记得在
for soldier循环里真正调用wordInString并根据返回值行动。
本单元小结 ✨
恭喜你在安息云峰攻克了黑魔法雕像!这一单元你掌握了字符串处理里非常实用的一项技能——子串匹配。你理解了子串"连续且顺序一致"的定义,学会了用 len 和 string[i] 下标访问字符、用 == 逐字符比较;你既见识了用 needleIndex 计数器的单指针滑动法,也亲手写出了更通用的双重循环法——外层枚举起点 i、内层用 string[i+j] 对齐 word[j]、不匹配就 break、比到最后一位就 return True。最后你把这套算法封装进 wordInString,在"高原者"关里精准挑出名字含 "mac" 的高地人。来回顾一下核心概念:
| 核心概念 | 关键点 | 对应内容 |
|---|---|---|
| 子串定义 | 连续 + 顺序一致的一段字符 | 8.1 |
| haystack / needle | 长字符串里找短子串 | 8.1 |
| 下标访问 | len(s) 与 s[i] | 8.2 |
| 逐字符比较 | 用 == 比对单个字符 | 8.2 |
| 单指针滑动 | needleIndex 计数,断则重置 | 8.3 |
| 双重循环 | 外层选起点 i、内层比对 j | 8.4 |
| i+j 下标对齐 | string[i+j] ↔ word[j] | 8.4 |
| break 与完整匹配 | 不合就断、全对就返回 True | 8.4 · 高原者 |
| 时间复杂度 | 朴素法 O(n×m) | 8.6 |
| 内置替代 | in / find / index | 8.6 |
能在一大堆字符里精准捞出那根"针"、把算法优雅封装成函数的英雄,
才是云峰之上真正沉着的程序员。继续向雪山之巅挺进吧,勇敢的程序员!🏔️⛰️🔍
扣哒世界 编程知识 · 计算机科学 5(安息云峰):第八单元
扣哒世界教研团队